 EN

具身智能,从仿真走向真实世界
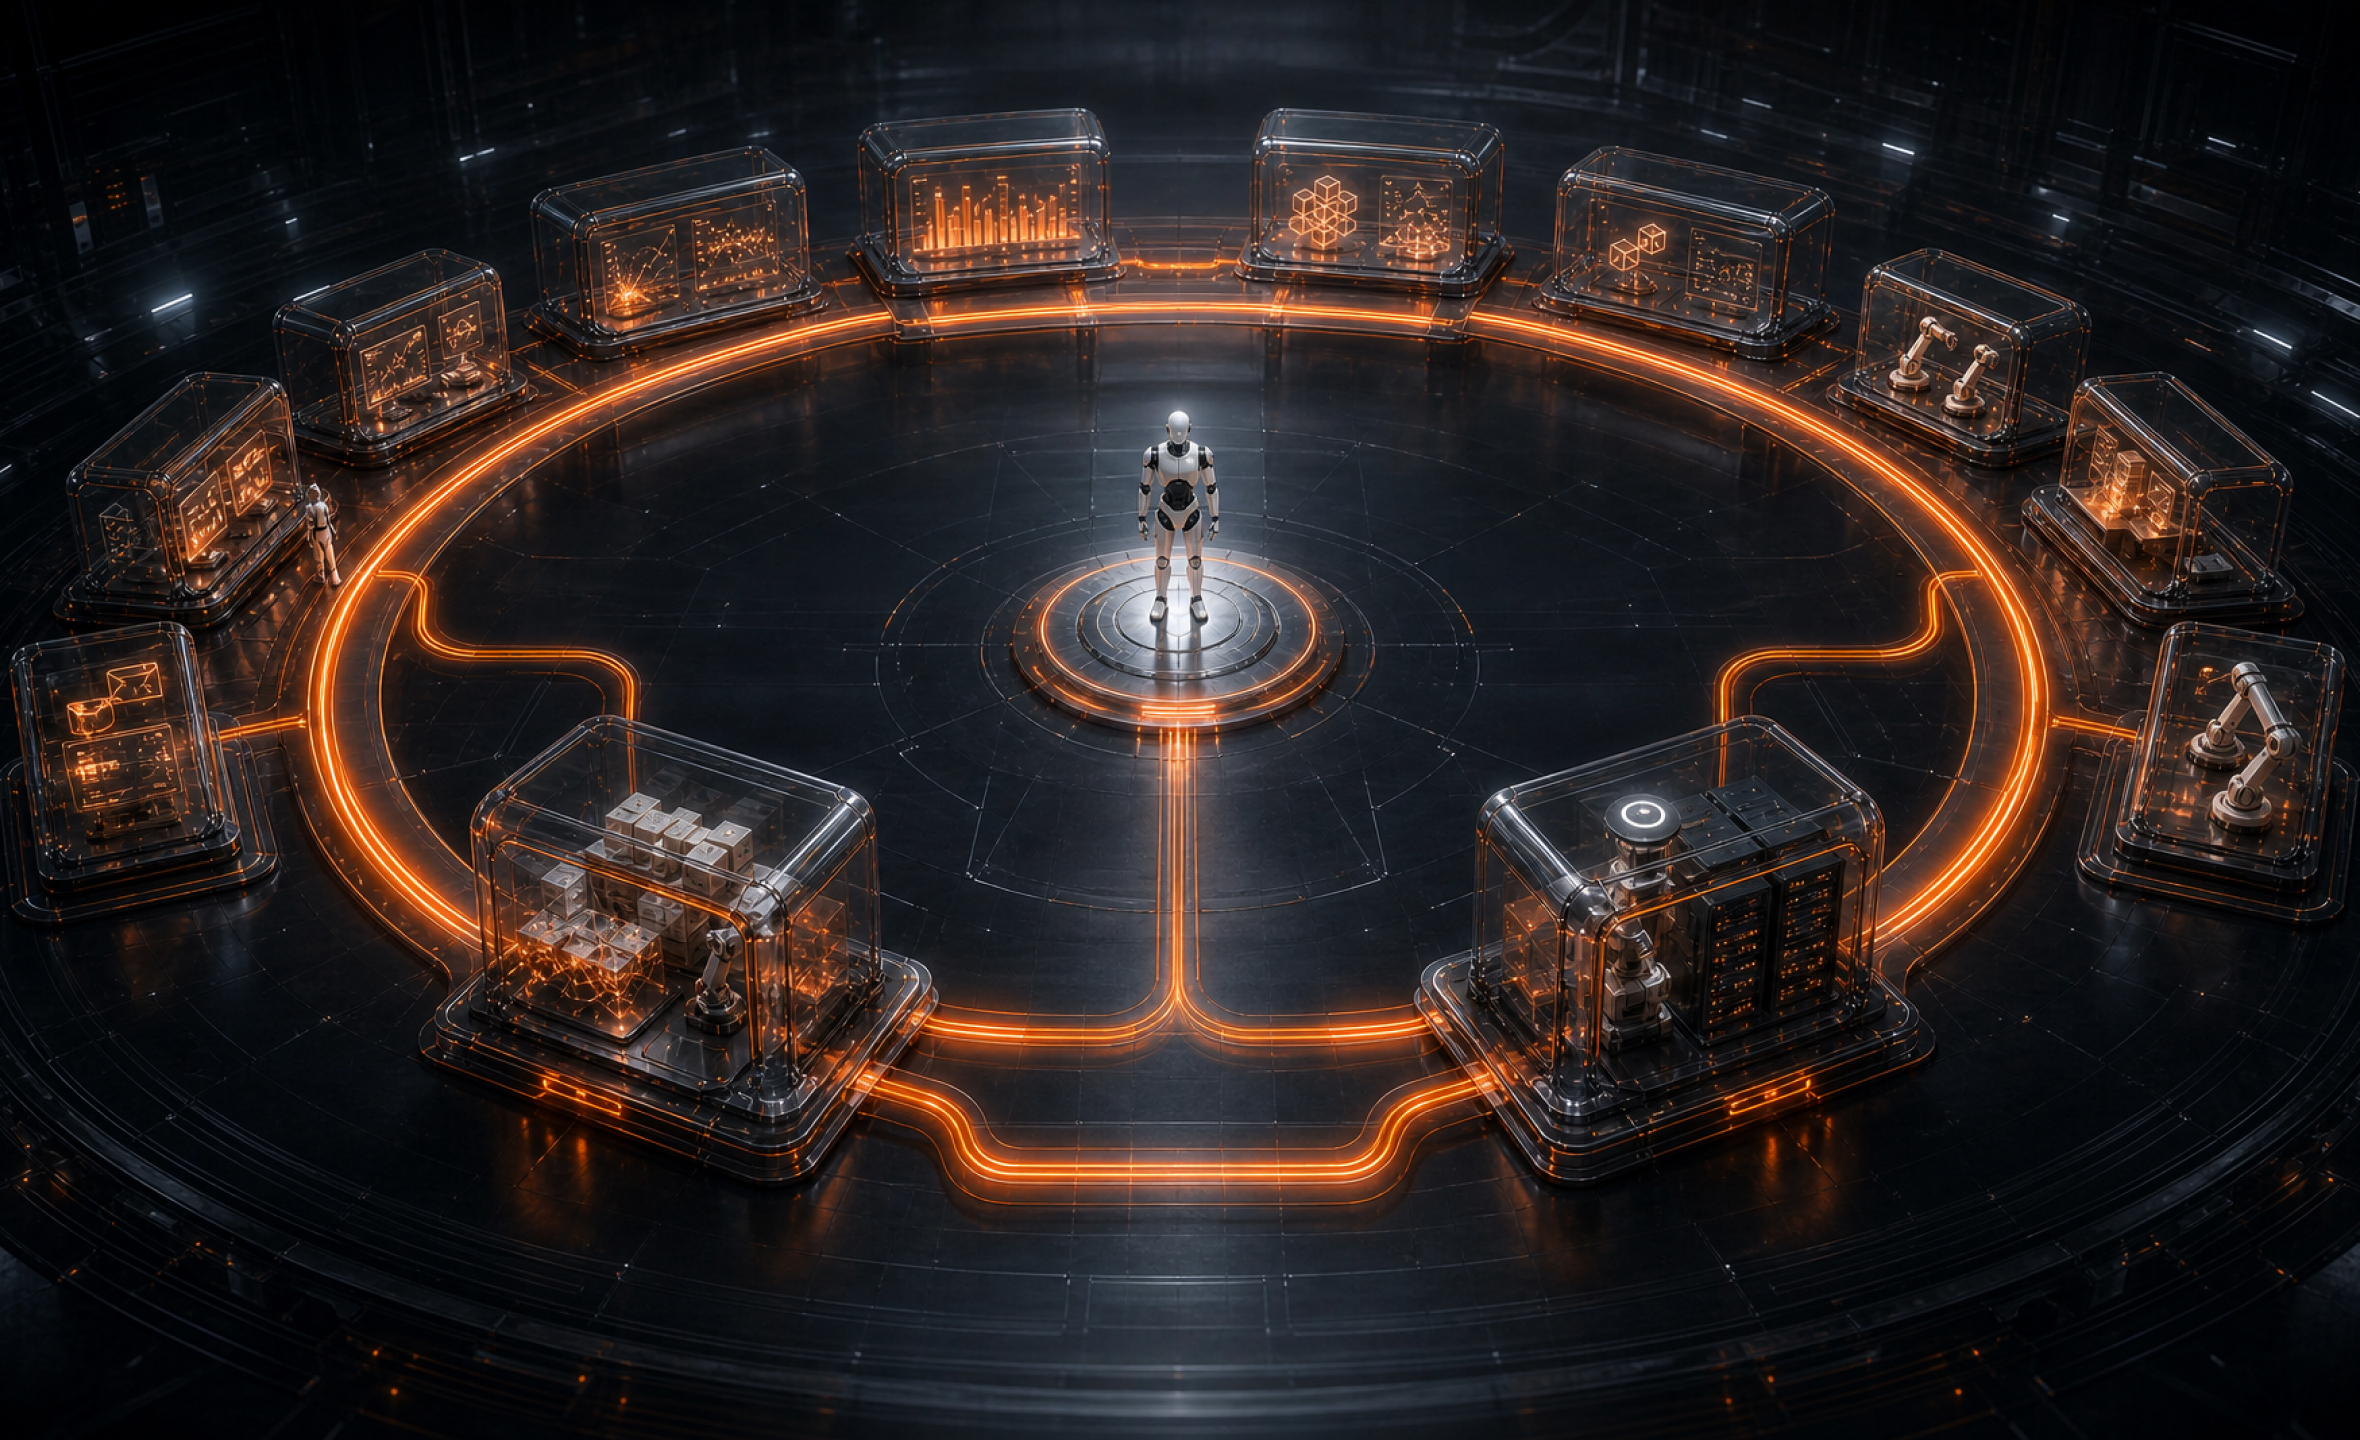
摩尔线程以 MUSA 统一系统架构与全功能 GPU 为算力底座,打造覆盖“仿真—训练—部署”全链路的国产化具身智能解决方案,让机器人学得更快、落地更稳。
全功能 GPU:“算渲仿”一体化算力底座
具身智能正成为 AI 进入物理世界的核心路径。从仿真中的策略学习,到真实环境中的部署运行,每一个环节都对算力提出苛刻要求。
仿真要高吞吐
物理、渲染、AI 三类计算需要协同运行,大规模并行环境才能产生足够数据
训练要大规模
VLA(视觉—语言—动作)大模型的训练依赖稳定扩展的集群算力
部署要低时延
端侧机器人需要在毫秒级闭环中同时运行多个模型
摩尔线程全功能 GPU 在单颗芯片上同时集成 AI 计算、图形渲染、物理仿真与科学计算、超高清视频编解码四大引擎,并配套自主 MUSA 软件栈与全链路工具,以“渲染+仿真+AI 训推”一体化的通用算力,成为业界少数能够同时支撑具身智能云端训练、仿真模拟与端侧部署的通用 GPU 底座。
从云到端,全栈算力布局
以全功能 GPU 底座为根基,摩尔线程依托夸娥智算集群、自研仿真平台 MT Lambda 及端侧 SoC 芯片,已经形成“云边端”协同的产品与能力布局。
云端训练
MTT S5000 智算卡 + 夸娥智算集群
支持万卡级高效互联,可扩展至十万卡规模,满足 VLA 大模型训练需求
仿真模拟
MT Lambda 平台
物理、渲染、AI 三引擎同芯协同,大规模并行仿真与合成数据生成
端侧部署
长江 SoC / MTT E300 AI 模组
集成多功能 GPU、算力高达 50 TOPS,支持多种端侧机器人关键设备上并发推理
具身智能仿真平台
MT Lambda 是摩尔线程推出的国产首个全栈具身智能仿真平台。依托自主 MUSA 架构、平台将物理、渲染、AI 三大引擎统一于单芯片协同计算,实现统一调研与数据掌控,从仿真底座服务、核心引擎、上层框架与工具、端侧打通“场景资产—并行仿真—合成数据—策略训练—仿真评测—真机部署”全链路,为具身智能从虚拟探索到真实落地提供一站式支撑。
物理仿真与数据合成
面向物理仿真和数据合成,提供多物理场统一求解能力,并支持 MuJoCo-Warp-MUSA、Newton-MUSA、MT AlphaCore 等物理引擎或组件。
策略训练与评估
基于业界领先的物理引擎和渲染引擎,采用主流强化学习框架和算法,支持多种任务类型,包括经典控制、机械臂操作、运动追踪和速度控制,支持宇树 G1、Go1/Go2 等多种机器人平台,为具身智能提供完整的策略训练、评估和可视化工具链。
AI 训练套件
面向生产级 AI 训练,提供训练框架、AI 框架和训练辅助工具,提供主流模型在摩尔线程全功能 GPU 上运行的高效训练方案,支持高达十万卡规模的训练过程,满足大规模计算需求。
全功能 GPU 加速具身智能仿真训练
相较于将图形渲染、物理计算和 AI 计算分配到不同设备的分立方案,全功能 GPU 将三类计算统一在同一硬件和软件架构中,并共享高速显存,有助于减少跨芯片、跨显存的数据搬运、格式转换和系统适配开销。
对于机器人“感知—物理反馈—决策执行”的高频闭环,视觉观测、物理状态和策略计算可以在统一算力底座上协同运行,降低数据传输和同步等待带来的开销,改善渲染帧与物理状态的时序对齐。
在仿真训练过程中,这种统一架构能够支撑更多并行环境同时运行,加快机器人状态更新、视觉数据生成和策略采样,使训练数据更快进入模型更新环节,并缩短“仿真采样—策略训练—仿真评测”的迭代周期。各组件通过任务配置、场景状态、观测数据、动作数据和模型 checkpoint 协同衔接,形成从场景准备、并行仿真、数据生成、策略训练到仿真评测的完整调用链路,为具身智能模型和运控策略的持续优化提供统一的计算基础。
Sim2Real:训推协同
围绕“虚实协同训练需求”,摩尔线程通过统一架构的算力平台将仿真数据生成、云端模型训练、端侧推理和真实数据回流连接起来,用于持续校准仿真策略与真实环境之间的差异。
物理域差距
针对摩擦、接触力学和刚度等物理差异,将真实机器人运行数据与仿真策略进行对照,用于校准仿真参数,并结合扰动训练和策略优化提升模型对物理变化的适应能力。
视觉域差距
针对光照、材质和传感器噪声等差异,通过高保真渲染、场景随机化和视觉增强,在多样化视觉数据中提升模型的泛化能力。
动作模型差距
针对仿真动作与真实机器人执行结果不一致,通过控制参数调整、动作约束、增量回放和真实数据再训练,逐步修正策略输出与实际执行之间的偏差。
双臂机器人实现 GPU 卡的插拔
典型应用场景
RoboEvolve 是基于 MT Lambda 平台构建的具身智能任务编排与评测工具。本案例以标准化机器人任务为入口,展示各组件如何协同完成任务配置、数据生成、策略训练和仿真评测。在真实实验中,RoboEvolve可协助用户加速完成具身智能仿真和训练全链路,通过32卡MTT S5000 运行 3 天,即可完成VLA x RoboTwin 2.0 模型训练任务。
场景与资产准备
并行仿真与数据生成
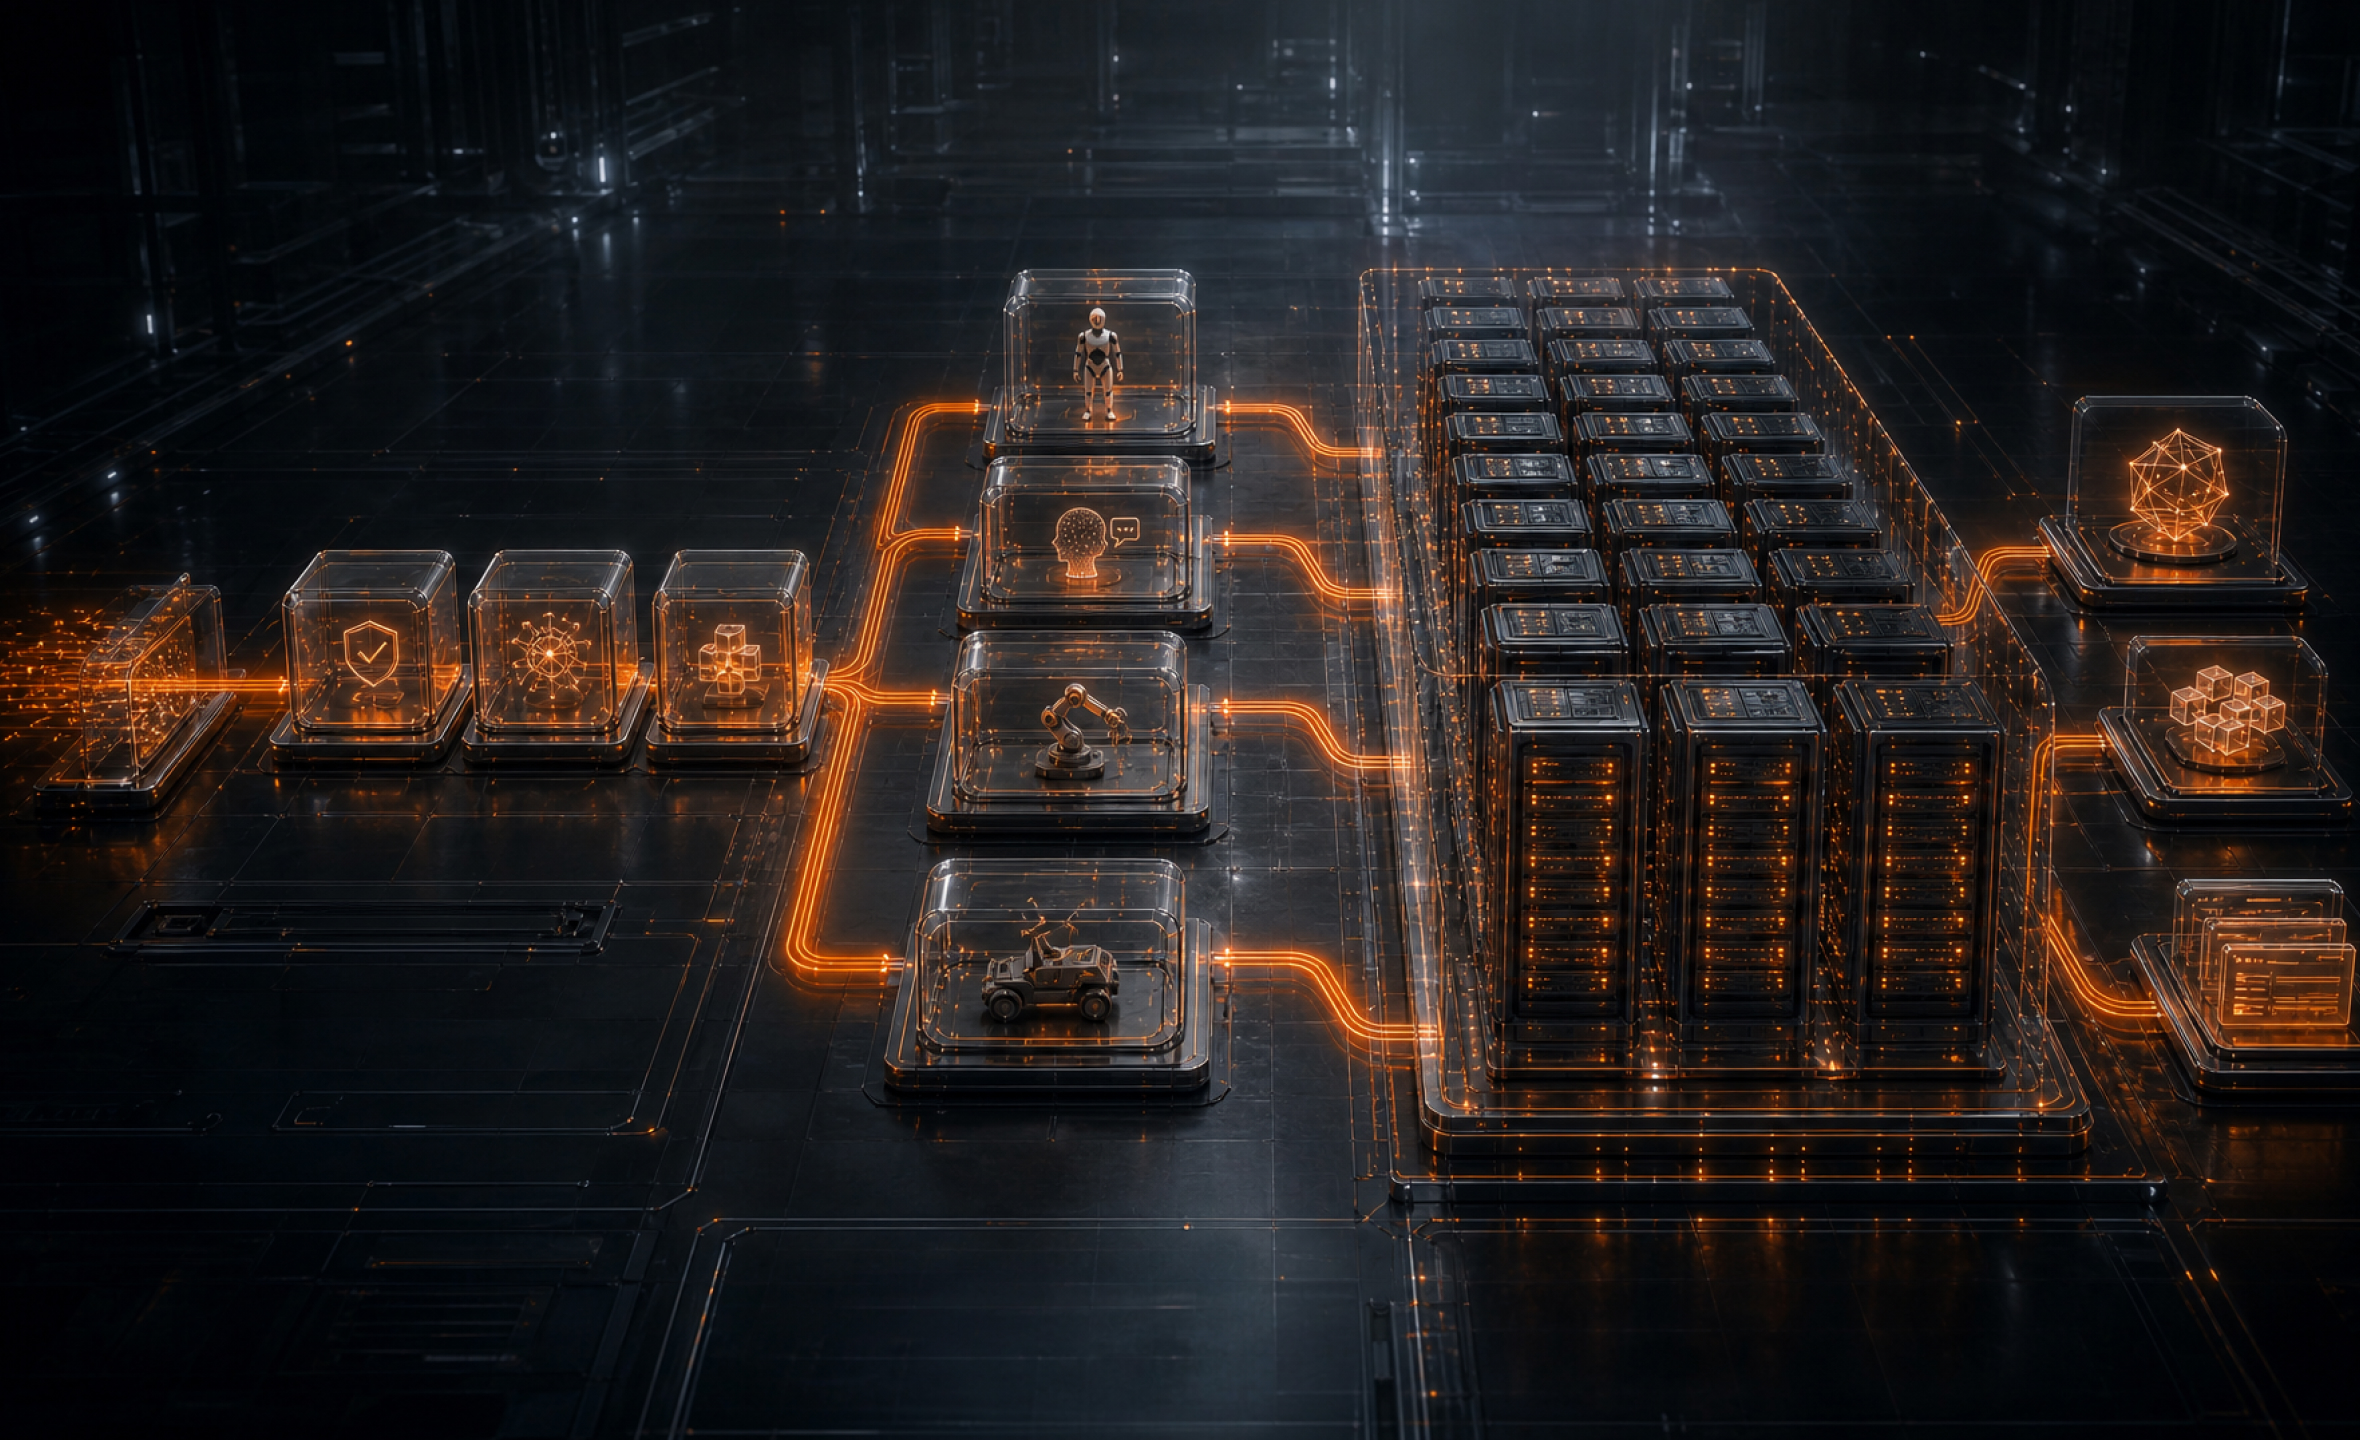
训练路径选择
仿真评测